
티스토리 뷰
✔ Summary
최신 Image Detector 는 백본(Backbone)과 헤드(Head)라는 두 부분으로 나뉜다.
백본(Backbone)은 입력이미지를 feature map으로 변형시켜주는 부분이다.
ImageNet 데이터셋으로 pre-trained 시킨 VGG16, ResNet-50 등이 대표적인 Backbone이다.
헤드(Head)는 백본에서 추출한 feature map 의 location 작업을 수행하는 부분이다.
헤드에서 predict classes 와 bounding boxes 작업이 수행된다.
Dense Prediction 헤드를 사용하는 One-Stage Detector는 대표적으로 Yolo, SSD 등이 있다.
Predict classes 와 Bounding box regression 부분이 통합되어 있는 것이 특징이다.
Sparse Prediction 헤드를 사용하는 Two-Stage Detector는 대표적으로 Faster R-CNN, R-FCN 등이 있다.
Predict classes 와 Bounding box regression 부분이 분리되어 있는 것이 특징이다.
넥(Neck)은 백본과 헤드를 연결하는 부분으로, feature map을 refinement(정제), reconfiguration(재구성)한다.
대표적으로 FPN(Feature Pyramid Network), PAN(Path Aggregation Network), BiFPN, NAS-FPN 등이 있다.
이렇게만 설명하면 어려우니 처음부터 설명해보자.
유명한 이미지 데이터셋, MNIST 와 같은 데이터셋에서는 3개의 층을 가지는 CNN으로도 높은 classification 성능을 얻을 수 있다.
하지만 CIFAR 이나 ImageNet 과 같이 좀 더 도전적인 데이터셋에서는 얕은 네트워크로는 한계가 있다.
따라서 연구자들은 과거부터 Layer 를 더 깊게 쌓으려고 노력했다.
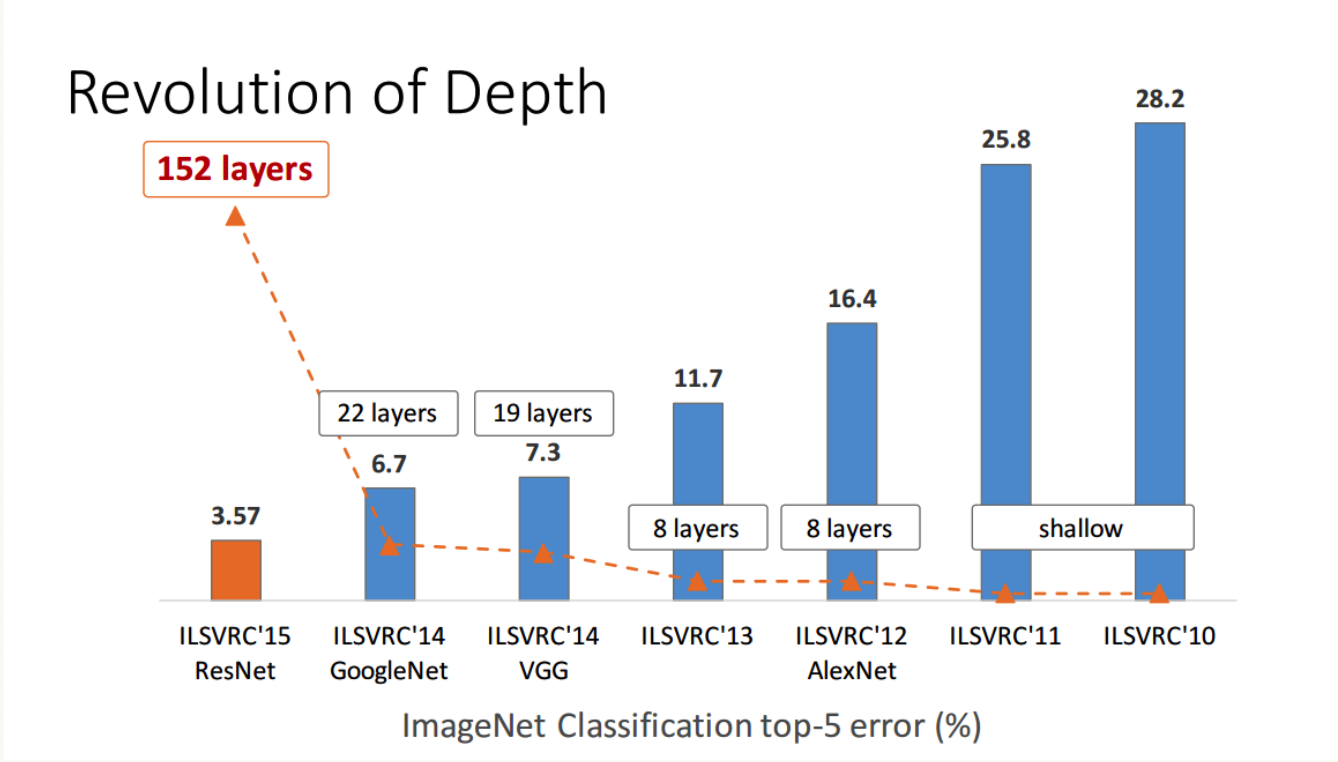
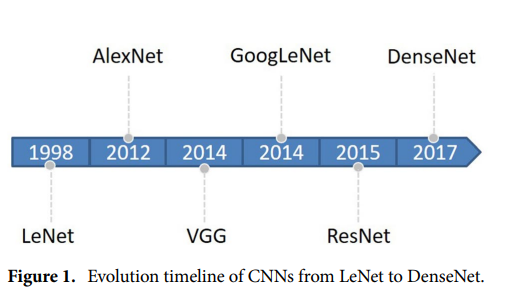
어쩌구 저쩌구 ResNet 이 층수를 더 높게 쌓아서
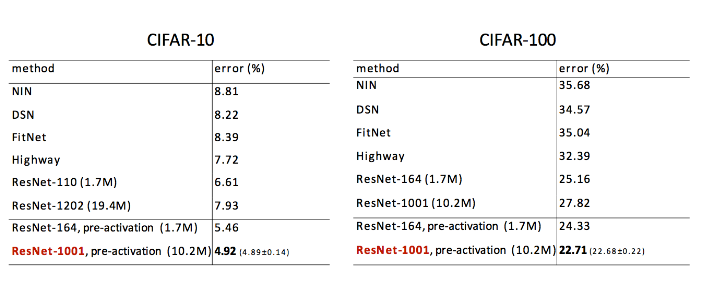
Image Classification 에서 위와 같은 성과를 거두었다.
하지만, ResNet 또는 더 깊은 신경망은 단지 Image Classification 에만 사용되는 것이 아니다.
Detection, Segmentation, Pose Estimation, Depth Estimation 등에서 일명 Backbone으로 사용된다.
✔ Backbone
: 등뼈, 뇌(입력)와 몸의 각 부위(출력)의 신경을 이어주는 역할
즉, 입력이 처음 들어와서 출력에 관련된 모듈에 처리된 입력을 보내주는 역할
몸의 각 부분을 여러가지 task라고 생각하면, ResNet과 같은 Classification Model 은 입력을 받아서 각 task에 맞는 모듈로 전달해주는 역할
결국 객체를 검출하든(Detection) 영역을 나누든(Segmentation) NN은 입력 이미지로부터 다양한 feature를 추출해야 한다.
그 역할을 Backbone 네트워크가 하는 것이다.
참고자료
https://ddangjiwon.tistory.com/103
Backbone(백본)에 대해
Object Detection Models 최신 detector는 주로 백본(Backbone)과 헤드(Head)라는 두 부분으로 구성된다. 백본은 입력 이미지를 feature map으로 변형시켜주는 부분이다. ImageNet 데이터셋으로 pre-trained 시킨 VGG16, R
ddangjiwon.tistory.com
https://dnddnjs.github.io/cifar10/2018/10/09/resnet/
CIFAR-10 정복 시리즈 1: ResNet
CIFAR-10 정복하기 시리즈 소개 CIFAR-10 정복하기 시리즈에서는 딥러닝이 CIFAR-10 데이터셋에서 어떻게 성능을 높여왔는지 그 흐름을 알아본다. 또한 코드를 통해서 동작원리를 자세하게 깨닫고 실
dnddnjs.github.io